Analyses de marché, contrats, comptes rendus de réunion : les collaborateurs confient chaque jour à l’IA générative des informations que leur organisation n’aurait jamais laissé sortir autrement. Faut-il interdire son utilisation en entreprise ? Une solution qui n’en est pas une : les usages se déplacent alors simplement hors des radars. Et c’est là tout l’enjeu des organisations vis-à-vis de l’IA : développer son utilisation tout en la cadrant pour garder la maîtrise de leurs données.
Cet article s’appuie sur un webinaire de la Semaine de la Souveraineté Numérique avec Roger Langlais (SFIL) et Nicolas Jacquey, qui pilote le développement de SafeBrain, notre plateforme d’IA générative. Le replay est disponible en fin d’article.
Quand l’IA est gratuite, vos données paient l’addition
Les assistants d’IA grand public collectent bien plus que les questions qu’on leur pose. Selon la dernière étude de Surfshark, publiée en mars 2026, les dix applications les plus populaires recueillent en moyenne 14 types de données sur les 35 référencés par l’App Store. Meta AI en collecte 33, ChatGPT 17, soit sept de plus que lors de l’édition précédente (source). Ces informations ne servent pas qu’au fonctionnement du service : elles alimentent aussi l’analyse, la personnalisation et le marketing.
« Nous sommes de la génération « nos emplettes sont nos emplois ». Avec l’IA, il faudrait dire « nos requêtes sont nos emplois ». Quand un service est gratuit, c’est l’utilisateur qui devient le produit, et ses données partent nourrir des acteurs qui ne sont pas européens. »
Nicolas Jacquey, Expert IA chez Jamespot
En entreprise, le risque prend une autre dimension, à travers des requêtes très ordinaires. Un chef de produit qui demande une analyse de marché en citant le lancement d’un nouveau modèle livre une information stratégique.
Un salarié qui cherche comment signaler le harcèlement d’une collègue expose son entreprise à un risque de réputation. Ou encore un acheteur qui fait relire un contrat sous accord de confidentialité sort du cadre qu’il a signé avec son partenaire.
Ces usages sortent du cadre du RGPD et, de plus en plus, de l’AI Act. Ils se développent pourtant sans que l’organisation en ait connaissance : le fameux shadow AI. Et chercher à le bloquer ne sert à rien. L’IA occupe déjà une place trop importante dans le quotidien des collaborateurs pour qu’ils y renoncent.
Reste à encourager l’IA au sein des équipes, sans que les données de l’organisation finissent éparpillées aux quatre vents.
La fuite de données : le risque majeur de l’IA
Le cas SFIL : déployer l’IA générative dans une banque publique
La SFIL est une banque publique de développement du groupe Caisse des Dépôts. Elle finance le secteur public local, collectivités et hôpitaux, en partenariat avec La Banque Postale et la Banque des Territoires, ainsi que les grands contrats à l’exportation.
Comme elle gère des données particulièrement sensibles, la banque avait de bonnes raisons de se méfier de l’IA générative. À l’arrivée de ces outils, elle les avait d’ailleurs tous bloqués en interne, par sécurité.
Il y a deux ans, la direction générale et la direction de la transformation ont lancé SFIL GPT, construit sur la plateforme SafeBrain, avec deux objectifs : acculturer les collaborateurs à l’IA et gagner en efficacité opérationnelle.
Le projet a été mené en trois mois, appel d’offres compris, par une équipe de six personnes : trois à la DSI, deux à la direction de la transformation et une chargée de la conduite du changement aux ressources humaines. Aujourd’hui, l’outil est utilisé quotidiennement par l’ensemble des collaborateurs.
Partir de cas d’usage concrets
Plutôt que de sonder tous les collaborateurs, l’équipe projet a défini elle-même les premiers cas d’usage, répartis en deux familles :
- des agents propres à la SFIL, alimentés par des bases de connaissances internes : procédures de conformité, ressources humaines, support informatique ;
- des usages d’efficacité opérationnelle : traduction de documents, synthèses, comptes rendus de réunion et un agent « généraliste » pour toutes les questions du quotidien.
Une cinquantaine de collaborateurs « ambassadeurs » ont ensuite utilisé l’outil pendant deux mois pour faire évoluer ces cas d’usage avant le déploiement général.
Former à la classification des données avant d’ouvrir l’accès
La SFIL a choisi une charte de l’IA générale, valable pour toutes ses initiatives et pas seulement pour SFIL GPT. Cette dernière a été rédigée avec le DPO, la conformité, le RSSI et le service juridique, puis présentée aux partenaires sociaux.
« Une charte ne doit pas faire vingt pages, ni être connue seulement de ceux qui l’ont rédigée. Elle ne dit pas seulement ce qui est interdit : elle indique surtout comment bien faire, quand prendre des précautions et quand demander une validation. »
Roger Langlais, Directeur de l’architecture et de l’innovation numérique de la SFIL
La charte ne suffit pas pour autant. Avant d’accéder à SFIL GPT, chaque collaborateur doit réussir un module de formation en ligne sur la classification des données : savoir reconnaître une donnée sensible, et ce que l’on peut en faire. Les anciens collaborateurs ont dû le repasser. Toutes les données n’exigent pas le même niveau de confidentialité, mais chaque utilisateur doit savoir dans quel cas il se trouve.
Valider les nouveaux usages sans alourdir le processus
Chaque mois, un forum SFIL GPT réunit la DSI, la direction de la transformation, le RSSI, le DPO et la conformité. Les métiers y présentent leurs idées avec leur « activateur IA », un référent présent dans chaque direction, qui a succédé aux ambassadeurs. Pour chaque cas d’usage, cinq questions sont posées :
- Quelle est la finalité ?
- Quelles données seront utilisées ?
- Où sont-elles traitées et conservées ?
- Quelles seraient les conséquences d’une erreur ou d’une fuite ?
- Qui contrôle le résultat final ?
Après une estimation rapide du retour sur investissement, le cas d’usage passe devant un comité de projet IA, en présence de la direction générale. Comme la plateforme est déjà en place, un cas validé part directement en réalisation, sans repasser par le circuit classique des projets informatiques. Il est même souvent prototypé en direct pendant le forum.
Ce circuit ne concerne pas les usages individuels, accessibles à tous dans l’outil. Il s’applique aux agents partagés avec une équipe ou l’ensemble de l’entreprise, qui manipulent des bases de données communes et engagent davantage l’organisation.
Faire de la souveraineté un critère de sélection
Dans son appel d’offres, la SFIL avait posé une condition : une solution souveraine, ou au minimum une trajectoire claire vers la souveraineté. Les premiers usages portaient sur des données internes non sensibles, mais l’objectif était de traiter à terme les données les plus sensibles de la banque.
La plateforme était hébergée dès le départ dans un environnement qualifié SecNumCloud, le plus haut niveau de qualification délivré par l’ANSSI pour l’hébergement cloud. L’accès, quelques mois plus tard, à des modèles de langage (LLM) eux-mêmes hébergés en SecNumCloud a levé la dernière limite.
La pseudonymisation des requêtes, intégrée à SafeBrain, remplace les données identifiantes avant leur envoi au modèle. Elle a aussi facilité le travail du DPO. Chaque agent affiche désormais son niveau de classification et indique s’il pseudonymise les données, pour guider l’utilisateur.
Piloter dans la durée
Deux ans après le lancement, le pilotage repose sur une console de suivi : accès, consommation de tokens (l’unité de facturation des modèles), agents les plus utilisés, retours des utilisateurs. La DSI surveille surtout les coûts, la direction de la transformation l’adoption. Les tableaux de bord sont présentés chaque mois en comité de projet IA.
Les activateurs restent le premier levier. La SFIL leur consacre des journées de formation, avec des ateliers et des mises en situation pour apprendre à monter un cas d’usage et à accompagner leurs collègues. Le retour sur investissement n’a pas encore été chiffré, mais le changement de comportement est net.
« Au début, c’est nous qui allions vers les collaborateurs pour les pousser à s’emparer de l’IA. Aujourd’hui, la tendance s’est inversée : ce sont eux qui viennent réclamer de nouveaux cas d’usage. Pour certains, ouvrir SFIL GPT est devenu un réflexe dès qu’ils allument leur ordinateur. »
Roger Langlais
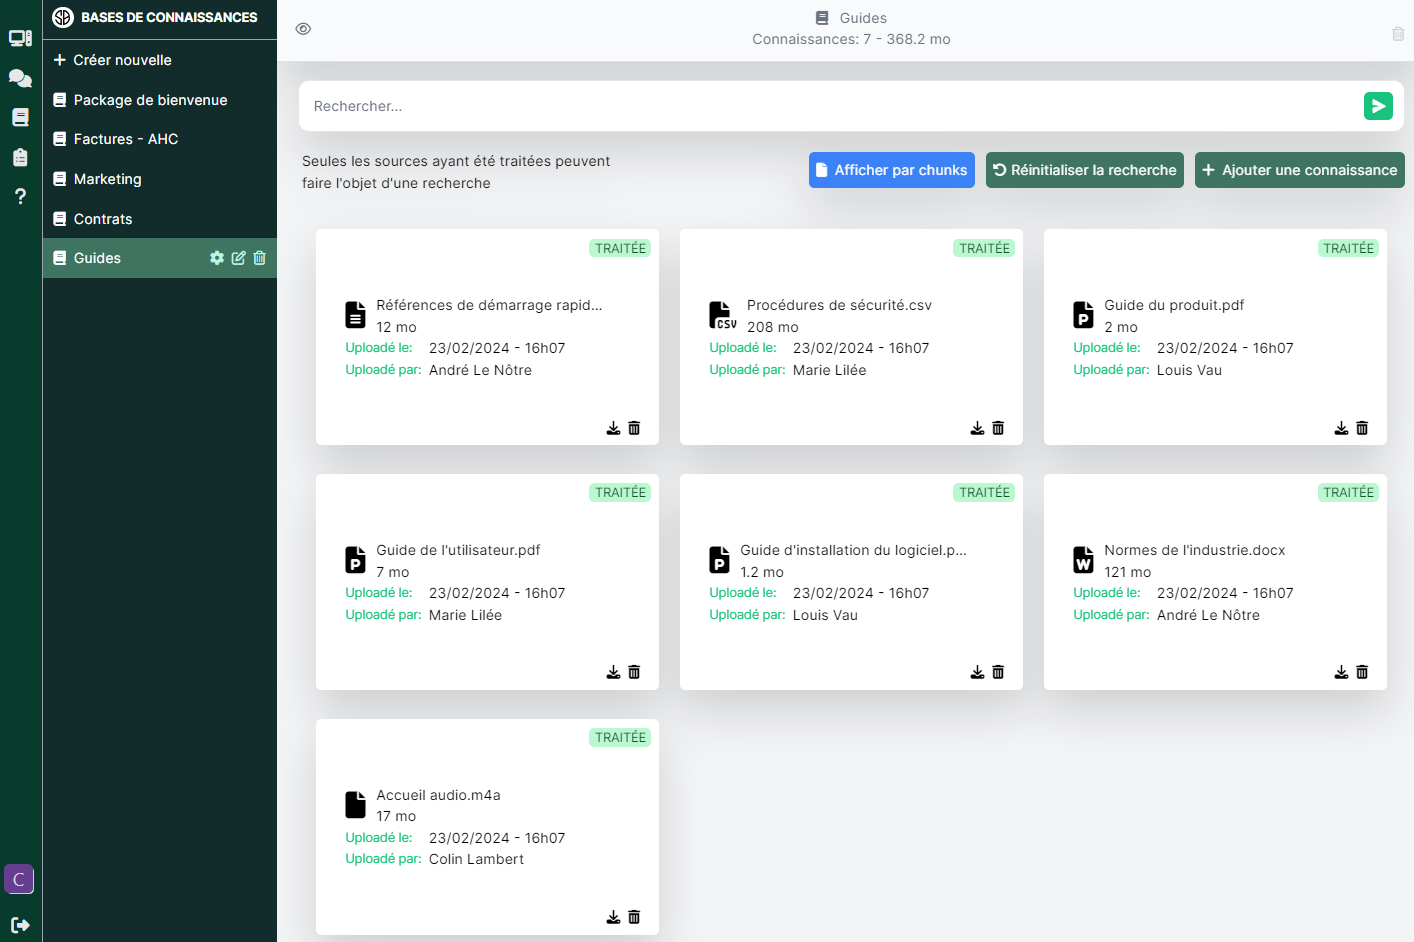
SafeBrain : l’IA générative sans perdre la main sur ses données
SafeBrain fait partie de la gamme Jamespot, aux côtés d’Open Agora, de Fast Intranet et de TeamWork. Cette plateforme d’IA générative répond à un double objectif : développer les usages de l’IA dans les organisations, tout en sécurisant son utilisation et en protégeant les données internes.
Une IA souveraine, hébergée en SecNumCloud
SafeBrain est hébergée dans un environnement qualifié SecNumCloud et certifié HDS pour les données de santé. Son éditeur est certifié ISO 27001 et labellisé Numérique France Garantie, le label délivré par Origine France Garantie aux solutions numériques conçues et opérées en France.
La plateforme donne accès à plus de quinze modèles de langage, dont ceux de Mistral AI et des modèles en poids ouverts hébergés dans son propre environnement : aucun éditeur de modèle ne peut ainsi réutiliser les données pour l’entraînement. Chaque organisation choisit les modèles qu’elle met à disposition et peut désactiver certaines fonctions, comme la recherche sur le web.
La pseudonymisation des données sensibles
Avant l’envoi d’une requête ou d’un document, SafeBrain repère et pseudonymise les informations sensibles : noms, adresses e-mail, IBAN, numéros de sécurité sociale, mais aussi des termes propres à l’organisation, comme les noms de clients ou de projets. Lors de l’analyse d’une enquête de satisfaction de patients, par exemple, le modèle ne reçoit jamais le nom d’un patient mécontent, seulement « personne 7 ». Le résultat, lui, s’affiche avec les vrais noms pour l’utilisateur autorisé.
Un espace cloisonné pour chaque équipe
Chaque direction dispose de son propre espace, avec ses agents, ses bases de connaissances et ses connecteurs vers le système d’information. L’espace des ressources humaines reste invisible pour l’équipe commerciale. Les conversations sont privées par défaut, et leur partage avec des collègues reste un choix de l’utilisateur.
Un suivi des usages au quotidien
Les administrateurs suivent les utilisateurs et les agents les plus actifs, la consommation de tokens et les droits d’accès. Ils repèrent les collaborateurs moteurs, ainsi que ceux qui ont besoin d’un accompagnement supplémentaire.
« Demain, chaque organisation apprendra à choisir le bon modèle pour le bon usage. Des modèles spécialisés vont apparaître pour certaines tâches, avec un double enjeu : la performance et la maîtrise de la consommation de tokens. »
Nicolas Jacquey
Comme la SFIL, déployez une IA générative souveraine adaptée à votre organisation et à vos métiers. Prenez rendez-vous pour découvrir la solution SafeBrain et identifiez vos premiers cas d’usage.
Réserver une démonstration
Encourager plutôt qu’interdire
Le shadow AI naît presque toujours d’un manque comme un outil interne absent, trop lent ou trop limité dans ses fonctionnalités. L’expérience de la SFIL montre qu’un cadre clair, une formation à la classification des données et une gouvernance légère permettent de faire l’inverse : ouvrir largement l’IA aux collaborateurs, puis l’étendre aux données les plus sensibles, sans renoncer à leur protection.
Revoir le webinaire en intégralité

Passionné par le numérique et grand amateur d'écriture qui apprécie tout particulièrement transmettre ses connaissances à d'autres personnes.